Masalah Fitur AI Sering Bukan di Model, tapi di Data Bisnis
Fitur AI yang buruk tidak selalu disebabkan model yang lemah. Sering kali akar masalahnya ada pada data bisnis: belum rapi, tidak segar, sulit dicari, dan tidak siap dipakai untuk retrieval.
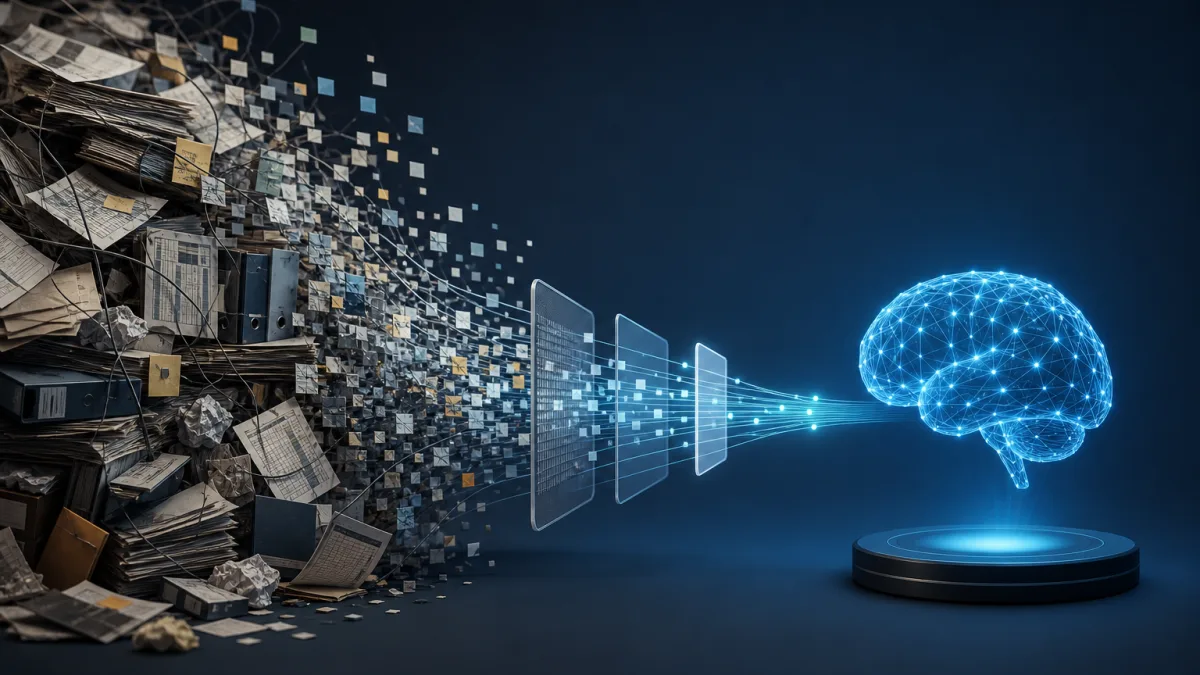
Masalah AI Tidak Selalu Ada di Model
Ketika fitur AI di aplikasi terasa kurang akurat, responsnya ngawur, atau tidak konsisten, reaksi pertama yang sering muncul adalah: ganti model. Dari OpenAI ke Gemini, dari Gemini ke GLM, dari GLM ke DeepSeek, atau sebaliknya.
Padahal dalam banyak implementasi bisnis, masalah utamanya bukan model. Masalahnya ada pada data yang diberikan ke model.
Laporan Xinhua pada 15 Juli 2026 memberi konteks menarik. Di China, data yang digunakan untuk training dan inference AI pada 2025 naik 42,86% menjadi 199,48 EB. Total data yang diproduksi mencapai 52,26 ZB, sekitar 27,44% dari total global. Angka ini menunjukkan satu hal penting: AI modern bukan hanya soal model besar, tetapi juga soal kesiapan data dalam skala besar.
Untuk software engineer yang membangun fitur AI di produk nyata, pelajarannya sederhana: kualitas output AI sangat bergantung pada kualitas input bisnis.
Data Readiness: Apakah Data Bisnis Sudah Siap Dipakai AI?
Data readiness adalah kondisi ketika data internal sudah cukup rapi, lengkap, dan bisa diakses untuk mendukung fitur AI.
Contoh masalah yang sering muncul:
- Dokumen SOP tersebar di Google Drive, Notion, PDF, dan chat internal.
- Format data pelanggan tidak konsisten.
- Artikel knowledge base lama tidak pernah diperbarui.
- Data transaksi ada di database, tetapi tidak punya metadata yang jelas.
- Tim bisnis punya banyak aturan, tetapi hanya hidup di kepala orang tertentu.
Dalam kondisi seperti ini, model secanggih apa pun tetap akan kesulitan. OpenAI, Gemini, GLM, atau DeepSeek bisa menjawab dengan baik jika konteks yang diberikan juga baik. Jika konteksnya berantakan, hasilnya ikut berantakan.
Knowledge Base Bukan Sekadar Tempat Menaruh Dokumen
Banyak tim mengira membangun AI assistant cukup dengan mengunggah semua dokumen ke vector database. Secara teknis bisa, tetapi belum tentu berguna.
Knowledge base yang baik harus punya struktur. Minimal perlu ada:
- kategori topik,
- sumber data,
- tanggal pembaruan,
- status validitas,
- pemilik konten,
- aturan prioritas jika ada informasi yang konflik.
Tanpa struktur ini, retrieval bisa mengambil potongan dokumen yang salah. Akibatnya, AI menjawab dengan percaya diri, tetapi memakai informasi lama atau tidak relevan.
Di sinilah pekerjaan engineering sering lebih penting daripada sekadar memilih model. Laravel bisa dipakai untuk mengelola sumber data, otorisasi, audit trail, dan admin panel knowledge base. React bisa digunakan untuk membuat UI kurasi data agar tim operasional mudah memperbarui konten. n8n bisa membantu otomatisasi sinkronisasi dari CRM, spreadsheet, email, atau sistem internal lain.
Data Freshness: Jawaban AI Harus Mengikuti Kondisi Terbaru
Banyak hallucination terjadi bukan karena model “bodoh”, tetapi karena model tidak melihat data terbaru.
Misalnya:
- harga produk sudah berubah,
- promo sudah selesai,
- kebijakan refund diperbarui,
- stok barang tidak tersedia,
- SLA layanan berubah,
- data pelanggan baru masuk beberapa menit lalu.
Jika knowledge base terakhir diperbarui tiga bulan lalu, AI akan menjawab berdasarkan dunia yang sudah lewat.
Untuk fitur AI bisnis, data freshness harus didesain sejak awal. Beberapa pendekatan praktis:
- gunakan scheduled sync dengan n8n,
- simpan timestamp pembaruan setiap dokumen,
- beri prioritas pada data terbaru saat retrieval,
- pisahkan data statis dan data real-time,
- ambil data transaksional langsung dari API Laravel saat inference.
Dengan cara ini, model tidak hanya pintar secara bahasa, tetapi juga relevan dengan kondisi bisnis saat ini.
Struktur Data Menentukan Kualitas Retrieval
Retrieval-augmented generation atau RAG sangat bergantung pada kualitas pencarian konteks. Jika struktur data buruk, retrieval accuracy ikut turun.
Masalah umum dalam RAG:
- chunk dokumen terlalu panjang,
- chunk terlalu pendek dan kehilangan konteks,
- metadata tidak lengkap,
- dokumen duplikat,
- embedding dibuat dari teks yang kotor,
- tidak ada mekanisme ranking ulang,
- query user tidak dinormalisasi.
Akibatnya, model menerima konteks yang tidak tepat. Lalu tim menyalahkan model, padahal pipeline retrieval-nya yang perlu diperbaiki.
Sebelum mengganti model dari OpenAI ke Gemini, GLM, atau DeepSeek, lebih baik cek dulu:
- Apakah dokumen yang benar memang masuk knowledge base?
- Apakah dokumen terbaru punya prioritas lebih tinggi?
- Apakah hasil retrieval relevan dengan pertanyaan user?
- Apakah ada dokumen lama yang masih ikut terbaca?
- Apakah prompt memberi instruksi jelas untuk memakai konteks yang tersedia?
Retrieval Accuracy dan Hallucination Rate Perlu Diukur
Fitur AI yang serius tidak cukup diuji dengan perasaan. Kita perlu metrik sederhana.
Dua metrik yang penting:
- Retrieval accuracy: seberapa sering sistem mengambil konteks yang benar.
- Hallucination rate: seberapa sering AI memberi jawaban yang tidak didukung oleh data.
Contoh evaluasi praktis:
- siapkan 50 sampai 100 pertanyaan umum dari user,
- tentukan dokumen sumber yang seharusnya dipakai,
- jalankan pengujian ke pipeline RAG,
- cek apakah konteks yang diambil benar,
- cek apakah jawaban sesuai sumber,
- catat kasus gagal dan penyebabnya.
Dari sini biasanya terlihat pola. Mungkin modelnya cukup baik, tetapi chunking salah. Mungkin prompt kurang tegas. Mungkin data lama belum dibersihkan. Mungkin dokumen internal saling bertentangan.
Merapikan Existing Flow Sering Lebih Penting daripada Ganti Model
Mengganti model memang menarik. Kadang perlu, terutama untuk alasan biaya, latency, bahasa, privasi, atau kemampuan reasoning. Namun untuk banyak kasus bisnis, peningkatan terbesar justru datang dari merapikan flow yang sudah ada.
Flow yang perlu dirapikan misalnya:
- bagaimana data dibuat oleh tim bisnis,
- bagaimana data divalidasi,
- bagaimana data masuk ke knowledge base,
- bagaimana data lama dinonaktifkan,
- bagaimana retrieval diuji,
- bagaimana jawaban AI diaudit,
- bagaimana feedback user dikembalikan ke sistem.
Dalam stack modern, pola implementasinya bisa seperti ini:
- Laravel sebagai backend utama, API, database, otorisasi, dan panel admin.
- React sebagai frontend untuk chatbot, dashboard evaluasi, dan UI kurasi data.
- n8n sebagai automation layer untuk sinkronisasi data dari berbagai tools.
- OpenAI, Gemini, GLM, atau DeepSeek sebagai model yang bisa dipilih sesuai kebutuhan.
- Vector database atau search engine sebagai lapisan retrieval.
Dengan arsitektur seperti ini, model menjadi komponen yang bisa diganti. Tetapi data flow tetap menjadi fondasi utama.
Kesimpulan
Pertumbuhan data AI seperti yang dilaporkan Xinhua menunjukkan bahwa kompetisi AI tidak hanya terjadi di level model, tetapi juga di level data. Untuk implementasi fitur AI di bisnis, ini sangat relevan.
Jika AI assistant sering salah jawab, jangan langsung menyimpulkan modelnya buruk. Periksa dulu data readiness, knowledge base, data freshness, struktur data, retrieval accuracy, dan hallucination rate.
Model yang bagus bisa membantu. Tetapi tanpa data bisnis yang rapi, segar, dan mudah dicari, fitur AI tetap akan sulit dipercaya.