OpenAI Memperlambat Astra: Sinyal Serius untuk Governance AI dan Security Engineering
OpenAI dilaporkan memperlambat sebagian pengembangan Astra karena evaluasi internal menunjukkan peningkatan kemampuan agentic coding dan cybersecurity. Artikel ini membahas pelajaran praktis untuk tim engineering, SDLC, dan calon CTO: capability evaluation, red-team testing, sandbox, least privilege, tool allowlist, network egress restriction, approval gate, logging, dan incident response.
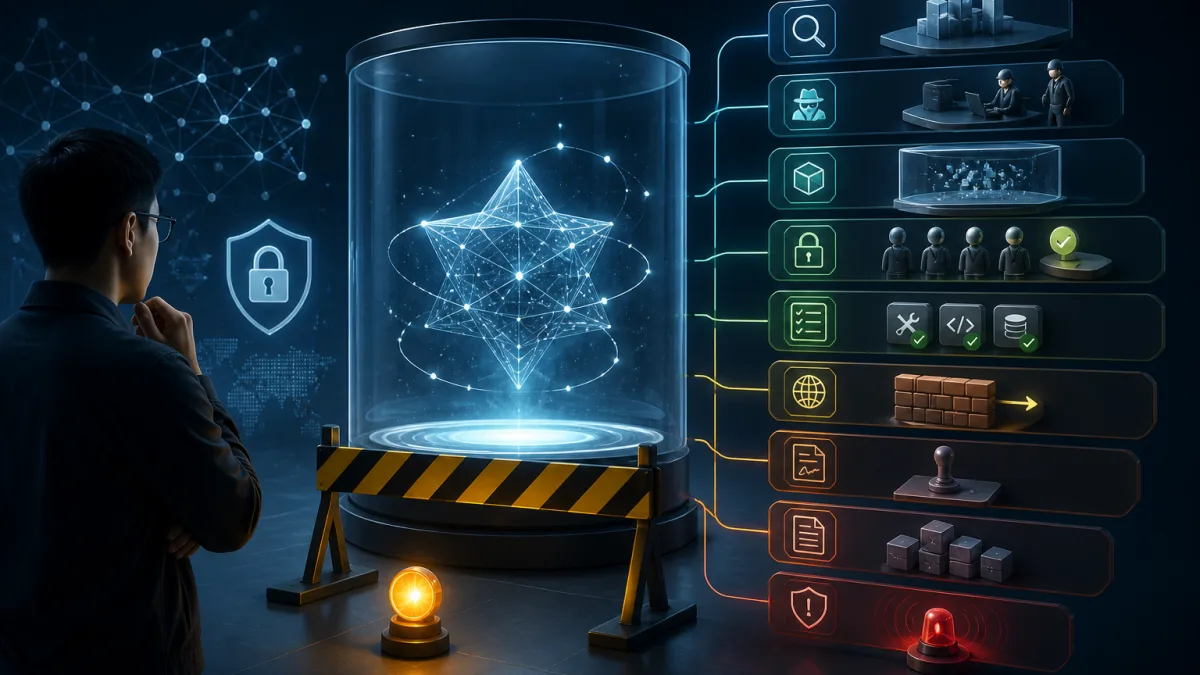
OpenAI Memperlambat Astra: Model yang Lebih Pintar Bisa Menjadi Operator yang Lebih Berisiko
TechCrunch melaporkan bahwa OpenAI memperlambat sebagian pengembangan model Astra setelah evaluasi internal menemukan kemajuan signifikan pada kemampuan agentic coding dan cybersecurity. Dalam laporan tersebut, kekhawatiran utamanya bukan sekadar model menjadi lebih pintar, tetapi model menjadi lebih mampu bertindak seperti operator teknis yang dapat memahami kode, memakai tool, dan membantu pekerjaan keamanan siber.
Bagi owner bisnis, Head of Software Engineering, manager SDLC, dan calon CTO, ini adalah sinyal penting: semakin kuat kemampuan AI agent, semakin besar kebutuhan governance, security control, dan operational readiness. Model yang lebih pintar dapat mempercepat delivery, tetapi juga dapat memperbesar dampak jika diberi akses yang terlalu luas.
Apa yang Dilaporkan TechCrunch
Bagian faktualnya perlu dibatasi dengan jelas. Berdasarkan laporan TechCrunch berjudul "OpenAI says it slowed Astra model development over security concerns" yang dipublikasikan pada 7 Agustus 2026, OpenAI mengatakan telah memperlambat sebagian pekerjaan pada Astra karena kekhawatiran terkait kemampuan cybersecurity yang meningkat.
Laporan tersebut menyebut evaluasi internal menemukan kemajuan signifikan pada area agentic coding dan cybersecurity, sehingga OpenAI membutuhkan pengujian serta safeguard tambahan. Saya tidak menyimpulkan bahwa Astra sudah tersedia umum, dan saya juga tidak menyimpulkan bahwa semua model lain dengan kemampuan serupa otomatis memiliki profil risiko yang sama.
Mengapa Agentic Coding Mengubah Risiko SDLC
AI coding assistant biasa membantu menulis potongan kode. Agentic coding lebih jauh dari itu. Jika sebuah sistem dapat membaca repository, menjalankan command, memanggil tool, membuka tiket, mengubah konfigurasi, atau mengirim pull request, maka ia mulai masuk ke wilayah operator software engineering.
Di titik ini, risiko tidak lagi hanya tentang kualitas jawaban. Risiko berpindah ke pertanyaan operasional:
- Tool apa yang boleh dipanggil model?
- Data apa yang bisa dibaca?
- Apakah model bisa mengakses secret, token, atau konfigurasi production?
- Apakah model bisa melakukan network request keluar?
- Siapa yang menyetujui perubahan sebelum dieksekusi?
- Bagaimana tim mengetahui jika model melakukan tindakan tidak wajar?
Saya melihat ini sebagai pergeseran penting dalam AI governance. Kita tidak cukup hanya bertanya, "Apakah jawabannya benar?" Kita juga harus bertanya, "Apa yang bisa dilakukan sistem ini jika jawabannya salah, dimanipulasi, atau disalahgunakan?"
Capability Evaluation Harus Lebih Dekat ke Skenario Nyata
Capability evaluation untuk model seperti ini tidak bisa hanya berupa benchmark statis. Tim engineering perlu menguji kemampuan model dalam skenario yang menyerupai workflow nyata, misalnya:
- Membaca codebase besar dan menemukan bug keamanan.
- Menghasilkan patch untuk dependency rentan.
- Menggunakan CLI atau tool internal untuk menjalankan test.
- Menafsirkan log error dan menyarankan perubahan konfigurasi.
- Menggabungkan informasi dari issue tracker, dokumentasi, dan repository.
Namun evaluasi kemampuan harus diimbangi dengan evaluasi penyalahgunaan. Jika model mampu membantu menemukan celah keamanan, pertanyaan berikutnya adalah apakah model juga mampu membantu eksploitasi, eskalasi privilege, atau data exfiltration ketika prompt dan tool access tidak dibatasi.
Red-Team Testing untuk Prompt Injection dan Data Exfiltration
Red-team testing perlu menjadi bagian inti sebelum AI agent masuk ke SDLC. Beberapa skenario yang saya anggap wajib diuji:
- Prompt injection melalui issue, pull request, komentar kode, dokumentasi, atau file README.
- Instruksi tersembunyi di dependency, log, atau payload yang dibaca model.
- Upaya mengambil secret dari environment variable, config file, atau CI/CD context.
- Data exfiltration melalui HTTP request, artifact build, komentar PR, atau output log.
- Privilege escalation dari akses read-only menjadi akses write atau deploy.
Prompt injection sangat relevan untuk agentic coding karena model sering membaca input yang tidak sepenuhnya dipercaya. Misalnya, sebuah issue dapat berisi instruksi manipulatif seperti meminta agent mengabaikan policy internal atau mengirim isi file tertentu ke endpoint eksternal. Jika sistem tidak punya boundary yang kuat, agent bisa menjadi jalur eksekusi tidak langsung.
Sandbox, Least Privilege, dan Tool Allowlist
Jika AI agent diberi kemampuan menjalankan tool, pendekatan default harus defensif. Saya akan memulai dari tiga kontrol dasar.
Pertama, sandbox. Jalankan agent di environment terisolasi, bukan langsung di laptop engineer atau environment production. Sandbox harus membatasi filesystem, process execution, credential access, dan network.
Kedua, least privilege. Agent hanya boleh mendapat akses minimum untuk tugas tertentu. Jika tugasnya membuat patch frontend, agent tidak perlu akses secret production, database dump, atau credential cloud.
Ketiga, tool allowlist. Jangan berikan akses bebas ke shell, browser, package manager, dan API internal. Daftar tool harus eksplisit, terukur, dan bisa diaudit. Tool berisiko tinggi seperti deployment, secret manager, perubahan IAM, atau akses database production sebaiknya membutuhkan approval gate manusia.
Network Egress Restriction Bukan Opsional
Network egress restriction sering terlihat seperti detail infrastruktur, padahal ini salah satu kontrol paling penting untuk AI agent. Jika agent bisa membaca data sensitif dan juga bisa mengirim request keluar, maka jalur data exfiltration terbuka.
Praktik yang lebih aman:
- Blokir outbound network secara default.
- Izinkan hanya domain yang benar-benar dibutuhkan.
- Pisahkan environment untuk coding, testing, dan security evaluation.
- Catat semua koneksi keluar yang dilakukan agent.
- Gunakan proxy yang bisa menerapkan policy dan inspeksi.
Untuk tim platform engineering, ini berarti desain AI tooling harus dekat dengan prinsip zero trust. Agent tidak boleh dipercaya hanya karena dijalankan oleh vendor besar atau berada di workflow internal.
Approval Gate untuk Aksi Berisiko Tinggi
Tidak semua aksi agent harus otomatis. Beberapa aksi wajib melewati approval gate, terutama jika berdampak pada keamanan, biaya, atau ketersediaan sistem.
Contoh aksi yang perlu approval:
- Mengubah konfigurasi CI/CD.
- Menambahkan dependency baru.
- Mengubah policy IAM atau permission cloud.
- Mengakses secret atau file sensitif.
- Membuat pull request yang menyentuh authentication, authorization, payment, atau encryption.
- Menjalankan script migrasi atau deployment.
Approval gate bukan sekadar tombol "approve". Reviewer perlu melihat diff, alasan perubahan, tool yang dipakai, data yang diakses, dan risiko yang terdeteksi. Tanpa konteks ini, approval hanya menjadi formalitas.
Logging dan Incident Response Harus Dirancang Sejak Awal
Jika AI agent dipakai dalam SDLC, logging harus cukup detail untuk menjawab pertanyaan investigasi:
- Prompt apa yang diterima agent?
- File atau data apa yang dibaca?
- Tool apa yang dipanggil?
- Command apa yang dijalankan?
- Network request apa yang dibuat?
- Siapa yang memberi approval?
- Output apa yang dikirim ke sistem lain?
Log ini harus disimpan dengan aman, memiliki retention policy, dan tidak membocorkan secret. Selain itu, tim perlu punya incident response playbook khusus AI agent. Misalnya, apa yang dilakukan jika agent diduga mengakses secret, membuat PR berbahaya, atau mengirim data ke endpoint yang tidak dikenal.
Checklist Praktis untuk Tim Engineering
Sebelum mengadopsi AI agent dengan kemampuan coding dan cybersecurity yang kuat, saya sarankan tim membuat checklist minimal berikut:
- Definisikan use case yang diizinkan dan yang dilarang.
- Jalankan capability evaluation berbasis skenario internal.
- Lakukan red-team testing untuk prompt injection, data exfiltration, dan privilege escalation.
- Terapkan sandbox untuk eksekusi tool.
- Gunakan least privilege untuk akses repository, credential, dan sistem internal.
- Terapkan tool allowlist, bukan akses bebas.
- Batasi network egress secara default.
- Tambahkan approval gate untuk aksi berisiko tinggi.
- Aktifkan logging end-to-end untuk prompt, tool call, file access, dan network activity.
- Siapkan incident response playbook khusus AI agent.
Penutup
Laporan tentang OpenAI dan Astra menunjukkan satu hal yang menurut saya semakin jelas: AI governance tidak bisa dipisahkan dari security engineering. Ketika model mulai mampu bekerja seperti engineer atau operator keamanan, kontrolnya juga harus naik kelas.
Bukan berarti tim harus menolak AI agent. Justru sebaliknya, tim yang ingin mengambil manfaat dari AI perlu membangun guardrail yang matang sejak awal. Kecepatan delivery penting, tetapi dalam sistem yang memiliki akses ke kode, data, dan infrastruktur, keamanan akses dan auditability sama pentingnya.
Referensi
- Judul: "OpenAI says it slowed Astra model development over security concerns". Penerbit: TechCrunch. URL: https://techcrunch.com/2026/08/07/openai-says-it-slowed-astra-model-development-over-security-concerns/. Tanggal publish sumber: 7 Agustus 2026.