Sebelum Membuat AI Knowledge Base, Rapikan Data Bisnisnya
AI knowledge base dan chatbot sales/support tidak akan bekerja baik jika sumber data bisnis masih tersebar, usang, ambigu, dan tanpa pemilik yang jelas. Artikel ini membahas cara menyiapkan data bisnis sebelum masuk ke retrieval, automation, dan integrasi AI.
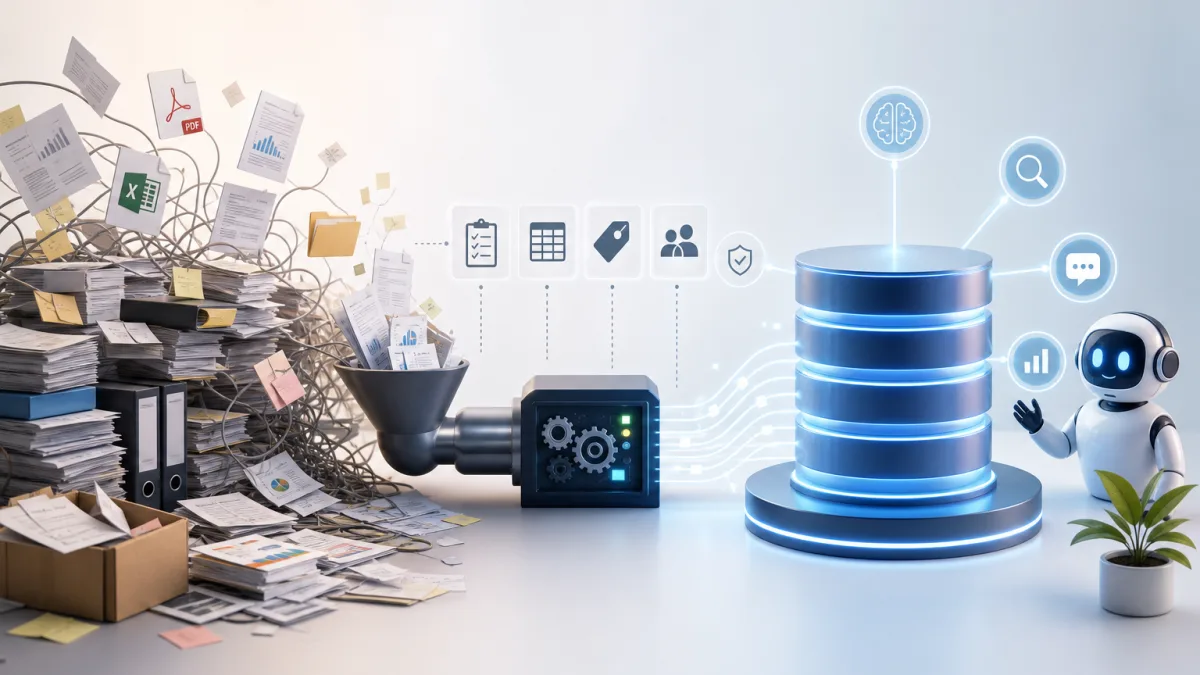
Sebelum Membuat AI Knowledge Base, Rapikan Data Bisnisnya
Saya cukup sering diminta membantu perusahaan membuat AI knowledge base atau AI chatbot untuk sales dan customer support. Biasanya ekspektasinya sederhana: tim ingin chatbot yang bisa menjawab pertanyaan pelanggan, menjelaskan produk, membantu sales, atau mengurangi beban pertanyaan berulang.
Namun begitu masuk ke tahap paling awal, yaitu meminta sumber informasi resmi, masalahnya mulai terlihat. Dokumen tersebar di Google Drive, Notion, PDF lama, spreadsheet, chat internal, dan file presentasi. SOP tidak selalu mutakhir. Katalog produk berbeda dengan daftar harga terbaru. FAQ tim sales tidak sama dengan FAQ customer support. Histori percakapan pelanggan tidak terstruktur. Data pelanggan bercampur dengan informasi operasional. Bahkan kadang tidak jelas mana dokumen yang menjadi system of record.
Masalah seperti ini sering dibahas seolah-olah AI-nya kurang pintar, prompt-nya kurang bagus, atau developer-nya belum cukup jago. Dari pengalaman saya, akar masalahnya sering lebih mendasar: data readiness dan proses bisnisnya belum rapi.
Pelajaran dari Forbes: AI Butuh Data Bisnis yang Siap Pakai
Artikel Forbes berjudul How To Get Your Business Data Ready For AI Agents karya Bernard Marr menekankan bahwa sebelum perusahaan serius memakai AI agents, data bisnis harus disiapkan dengan baik. Poin penting yang relevan adalah kesiapan data bukan hanya soal teknis, tetapi juga menyangkut governance, compliance, dan accountability.
Saya melihat hal yang sama ketika membangun AI knowledge base. AI tidak otomatis membuat data bisnis menjadi benar. AI hanya membaca, mengambil, dan menyusun jawaban dari sumber yang kita berikan. Jika sumbernya ambigu, usang, duplikat, atau tidak memiliki owner, chatbot akan mewarisi kekacauan itu.
Dengan kata lain, AI knowledge base bukan jalan pintas untuk menutupi proses bisnis yang belum tertata. Justru proyek AI sering menjadi cermin yang memperlihatkan seberapa rapi bisnis mengelola pengetahuannya sendiri.
Knowledge Base, Retrieval, Fine-Tuning, dan Training Model Itu Berbeda
Sebelum masuk ke framework, saya ingin meluruskan beberapa istilah yang sering tercampur.
Knowledge base adalah kumpulan informasi resmi yang digunakan sebagai sumber jawaban. Isinya bisa berupa FAQ, SOP, katalog produk, kebijakan refund, panduan onboarding, artikel help center, atau dokumentasi internal.
Retrieval adalah proses mencari bagian informasi yang paling relevan dari knowledge base ketika pengguna bertanya. Dalam arsitektur AI modern, chatbot tidak harus menghafal semua dokumen. Ia bisa mencari potongan informasi yang sesuai, lalu menyusun jawaban berdasarkan konteks tersebut.
Fine-tuning adalah proses menyesuaikan perilaku model dengan contoh tertentu. Fine-tuning bisa berguna untuk gaya bahasa atau pola tugas tertentu, tetapi bukan solusi utama untuk memperbaiki dokumen bisnis yang berantakan.
Training model adalah proses melatih atau memperbarui model pada level yang lebih besar. Ini biasanya mahal, kompleks, dan tidak dibutuhkan untuk kebanyakan chatbot sales atau support. Banyak kebutuhan bisnis justru lebih cocok diselesaikan dengan knowledge base yang rapi, retrieval yang baik, dan workflow yang jelas.
Kesalahan umum yang saya temui adalah perusahaan ingin langsung fine-tuning atau training model, padahal FAQ resminya saja belum disepakati. Dalam kondisi seperti itu, model yang lebih canggih tidak menyelesaikan masalah. Ia hanya membuat jawaban yang terdengar lebih percaya diri, meskipun sumbernya belum tentu benar.
Mengapa Chatbot Memberi Jawaban Buruk
Chatbot sales atau support akan bermasalah jika sumber datanya bermasalah. Beberapa contoh yang sering terjadi:
- Ada dua harga berbeda untuk produk yang sama.
- Katalog di website tidak sama dengan katalog yang dipakai tim sales.
- Kebijakan refund berubah, tetapi dokumen lama masih ikut terindeks.
- FAQ customer support menyebut proses A, sementara SOP operasional menyebut proses B.
- Dokumen tidak punya tanggal update atau pemilik yang bertanggung jawab.
- Histori chat pelanggan mengandung data sensitif dan belum dibersihkan.
- Tidak ada aturan kapan chatbot harus berhenti menjawab dan mengalihkan ke manusia.
Dalam situasi seperti ini, chatbot bisa menjawab dengan salah bukan karena teknologinya gagal, tetapi karena bisnis belum menentukan versi kebenaran yang harus dipakai. AI membutuhkan konteks yang jelas. Jika konteksnya saling bertentangan, hasilnya ikut tidak stabil.
Framework Praktis Menyiapkan Data Bisnis untuk AI Knowledge Base
Sebelum membuat AI knowledge base, saya biasanya menyarankan perusahaan melalui beberapa langkah dasar berikut.
1. Audit data bisnis
Mulai dengan inventarisasi semua sumber informasi: dokumen produk, SOP, FAQ, katalog, pricing, proposal, template email, help center, dan histori percakapan. Tandai mana yang masih valid, mana yang usang, mana yang duplikat, dan mana yang tidak boleh digunakan oleh AI.
Tujuan audit bukan membuat dokumentasi sempurna dalam satu malam. Tujuannya adalah mengetahui kondisi sebenarnya sebelum data masuk ke pipeline AI.
2. Buat data dictionary
Data dictionary membantu tim menyepakati arti istilah penting. Misalnya definisi customer aktif, lead qualified, paket enterprise, harga promo, refund eligible, atau SLA support. Tanpa definisi yang sama, AI bisa mengambil istilah dari dokumen berbeda dan menghasilkan jawaban yang membingungkan.
3. Tetapkan content ownership
Setiap kategori informasi harus punya owner. Pricing dimiliki oleh tim tertentu. SOP support dimiliki oleh tim tertentu. Katalog produk dimiliki oleh tim tertentu. Owner bertanggung jawab memastikan konten tetap akurat, bukan hanya mengunggah dokumen.
Tanpa ownership, knowledge base akan cepat menjadi tempat penumpukan file lama.
4. Tentukan system of record
System of record adalah sumber resmi yang dianggap paling benar. Untuk harga, mungkin sumbernya adalah sistem pricing internal. Untuk data pelanggan, mungkin CRM. Untuk kebijakan support, mungkin help center internal yang sudah disetujui.
AI knowledge base sebaiknya tidak mengambil data dari terlalu banyak sumber yang saling bertentangan. Tentukan sumber utama, lalu jadikan sumber lain sebagai pendukung jika memang diperlukan.
5. Normalisasi format
Dokumen perlu dirapikan agar mudah diproses mesin. Struktur heading harus jelas, tabel tidak ambigu, file lama perlu dikonversi, dan konten penting sebaiknya tidak terkunci dalam gambar atau PDF yang sulit dibaca.
Normalisasi ini terdengar membosankan, tetapi sangat berpengaruh terhadap kualitas retrieval.
6. Terapkan versioning dan approval
Setiap perubahan penting harus memiliki versi, tanggal update, dan status approval. Chatbot sebaiknya hanya membaca konten yang sudah disetujui. Draft, catatan internal, atau dokumen eksperimen tidak perlu ikut menjadi sumber jawaban pelanggan.
7. Atur access control dan redaction data sensitif
Tidak semua data boleh dibaca AI. Pisahkan data publik, internal, rahasia, dan data pelanggan. Lakukan redaction untuk informasi sensitif seperti nomor telepon, alamat, identitas pelanggan, detail kontrak, atau informasi lain yang tidak relevan untuk jawaban chatbot.
Access control penting terutama jika knowledge base dipakai oleh beberapa tim dengan hak akses berbeda.
8. Bangun ingestion pipeline
Ingestion pipeline adalah proses memasukkan dokumen ke sistem AI secara terkontrol. Idealnya pipeline ini mencakup validasi format, pemecahan dokumen menjadi bagian kecil, metadata, indexing, dan pengecekan apakah dokumen sudah approved.
Jangan jadikan ingestion sebagai proses manual yang asal upload. Jika pipeline tidak jelas, knowledge base akan sulit dipelihara.
9. Lakukan retrieval evaluation
Uji apakah sistem mengambil sumber yang benar saat diberi pertanyaan nyata. Evaluasi bukan hanya apakah jawaban terdengar bagus, tetapi apakah sumber yang diambil memang tepat, terbaru, dan sesuai konteks.
Pertanyaan yang perlu diuji misalnya: harga paket tertentu, cara refund, batasan layanan, status promo, proses komplain, atau perbedaan fitur antar produk.
10. Siapkan human escalation
Chatbot tidak harus menjawab semuanya. Untuk pertanyaan yang ambigu, berisiko tinggi, atau membutuhkan keputusan bisnis, chatbot harus bisa mengalihkan ke manusia. Ini bukan kelemahan. Ini bagian dari desain sistem yang bertanggung jawab.
11. Simpan audit log
Audit log membantu tim melihat pertanyaan apa yang diajukan, sumber apa yang digunakan, jawaban apa yang diberikan, dan kapan eskalasi terjadi. Log ini penting untuk debugging, compliance, dan perbaikan knowledge base dari waktu ke waktu.
Contoh Workflow Bertahap yang Lebih Aman
Untuk perusahaan yang baru mulai, saya lebih suka pendekatan bertahap daripada langsung membuat chatbot yang bisa melakukan banyak aksi.
Tahap pertama, rapikan FAQ dan katalog yang sudah disetujui. Pastikan harga, fitur, kebijakan, dan istilah penting tidak saling bertentangan.
Tahap kedua, buat chatbot read-only. Artinya chatbot hanya menjawab berdasarkan knowledge base, belum melakukan update CRM, membuat tiket, mengirim email, atau menjalankan follow-up otomatis.
Tahap ketiga, uji dengan pertanyaan nyata dari sales dan customer support. Gunakan pertanyaan yang memang sering muncul, bukan hanya pertanyaan demo yang terlalu rapi.
Tahap keempat, monitor hallucination dan unanswered questions. Catat kapan chatbot menjawab tanpa dasar yang kuat, kapan ia mengambil sumber yang salah, dan pertanyaan apa yang belum punya jawaban resmi.
Tahap kelima, perbaiki knowledge base dan proses approval. Jangan langsung menyalahkan model jika sumber informasinya belum lengkap.
Tahap keenam, baru pertimbangkan integrasi dengan CRM atau aksi follow-up. Misalnya membuat lead, mencatat minat produk, membuat tiket support, atau mengirim ringkasan percakapan ke tim sales. Integrasi seperti ini sebaiknya dilakukan setelah sumber data, akses, audit log, dan aturan eskalasi sudah jelas.
AI Automation Dimulai dari Business Process Optimization
Bagi saya, AI automation yang sehat selalu berangkat dari Business Process Optimization. Software engineering membantu membangun sistem yang konsisten. Automation membantu mengurangi pekerjaan berulang. AI membantu memahami bahasa natural, mengambil informasi, dan membantu pengambilan keputusan operasional.
Tetapi urutannya penting. Jika proses bisnis belum jelas, automation hanya mempercepat kekacauan. Jika data bisnis belum rapi, AI hanya membuat kekacauan itu terdengar lebih meyakinkan.
Sebelum bertanya model AI mana yang paling bagus, perusahaan sebaiknya bertanya dulu: sumber informasi resmi kita apa, siapa owner-nya, kapan terakhir diperbarui, siapa yang boleh mengakses, dan bagaimana kita tahu jawaban AI benar?
Pertanyaan-pertanyaan ini mungkin tidak sepopuler demo chatbot yang terlihat pintar. Namun dari pengalaman saya, jawaban atas pertanyaan inilah yang menentukan apakah AI knowledge base akan berguna dalam operasional nyata atau hanya menjadi eksperimen sementara.
Penutup
Membuat AI knowledge base bukan sekadar proyek AI. Ini proyek merapikan pengetahuan bisnis. Teknologi retrieval, chatbot, dan automation bisa memberi dampak besar jika fondasinya benar. Namun fondasi itu tetap berupa hal-hal dasar: data yang jelas, proses yang disepakati, ownership, approval, access control, dan evaluasi berkelanjutan.
Jika bisnis ingin AI menjawab dengan baik, bisnis harus lebih dulu tahu jawaban resminya.
Referensi
- Judul: How To Get Your Business Data Ready For AI Agents. Penulis: Bernard Marr. Penerbit: Forbes. URL: https://www.forbes.com/sites/bernardmarr/2026/07/27/how-to-get-your-business-data-ready-for-ai-agents/. Tanggal publish: 27 Juli 2026.